Category: Meta-Artikel

Dokumentation dessen, was tatsächlich gebaut wurde und wie.

  • Ein Agent, 36 Skills, drei tote ZIPs: Wochenlauf-Protokoll vom 21. September 2026

    Every Monday an agent diffs the public skill library I build with against last week’s snapshot, rebuilds my Claude plugin when something changed, and writes this receipt. This is the run of September 21, 2026 — a receipt, not a case study.

    What the run found

    • The library now lives entirely in the public Git repo (the skills repository), installed as a Claude plugin marketplace (“lss-everything”, marketplace v1.6.0). The old zip packs still answer HTTP 403 on all three hosts — that channel has been closed for weeks; the pages themselves call the zips “dated snapshots”.
    • 35 → 36 skills. New this morning: reuse-agent-access — agents must test and reuse connectors and signed-in browser sessions that are already authorized before asking the human for yet another login. Anyone who runs several AI apps against the same accounts knows exactly why this exists.
    • Every one of the 35 existing skills grew by exactly +59 lines (+2,977 bytes). Two new standards were tiled into all of them by script: explain useful connections in every article opening (Sep 14) and reuse existing authorized access (Sep 21). A uniform delta across 35 files is the signature of standards-as-code: write the rule once, propagate it everywhere.
    • The Grokipedia emergency brake moved into the skill itself. The client-submission freeze (queue stuck since April) now sits at the very top of the skill and inside its description — until Sep 16 it lived in a sidecar file you could miss.

    What the run built

    Because the source changed, the run rebuilt my plugin: blitzmetrics-skills v2.6.0 — 36 skills, 114 files, 1.59 MB, claude plugin validate passed. On the way it caught three skills with broken YAML frontmatter (an unquoted colon inside the description: boil-the-ocean, one-session-client-onboarding, social-amplification-engine) — the same bug class the July run fixed once before, now in new files. Fix: description as a YAML block scalar, nothing else touched.

    What broke, where I guessed

    The registry web pages were not fetchable unattended — the fetch demands an interactive approval and nobody is present during a scheduled run. The repo served as primary source instead (the better source anyway; the page cross-check is simply missing this week). The version scheme was my guess: the old counter died with the zips, so v2.6.0 mirrors upstream marketplace 1.6.0 — a guess is a missing instruction, so it is documented here. Two legacy skills (personal-brand-strategist, personal-brand-website-agent) exist only in July’s zip pack and in no storage this run could reach; they are not bundled anymore, and updating the plugin drops them — recovery is the local copy in the Skill Files folder.

    One more first: this receipt published itself. The three previous runs ended as unpublished files because the site rejected unauthenticated posting; a stored application password closed that three-week gap today.

    SOP change (v1.3)

    From this run on: git diff against the repo instead of zip comparison, plugin built straight from the repo, manifest still written to Drive weekly. Open proposal: rewrite steps 2/2.5 of the scheduled task’s prompt, which still describe the dead zip mechanics. Previous receipt in this series: How I built my project system in one afternoon with Claude.

    Jeden Montag vergleicht ein Agent die öffentliche Skill-Bibliothek, mit der ich arbeite, mit dem Stand der Vorwoche, baut bei Änderungen mein Claude-Plugin neu und schreibt dieses Protokoll. Das hier ist der Lauf vom 21. September 2026 — eine Quittung, keine Fallstudie.

    Was der Lauf gefunden hat

    • Die Bibliothek lebt jetzt vollständig im öffentlichen Git-Repo (das Skill-Repository), installiert als Claude-Plugin-Marketplace („lss-everything”, Marketplace-Version 1.6.0). Die alten ZIP-Pakete antworten auf allen drei Hosts weiter mit HTTP 403 — der Kanal ist seit Wochen zu, die Seiten selbst nennen die ZIPs „dated snapshots”.
    • 35 → 36 Skills. Neu von heute Morgen: reuse-agent-access — Agenten sollen bereits autorisierte Zugänge (Connectoren, eingeloggte Browser-Profile) erst testen und wiederverwenden, bevor sie den Menschen zum x-ten Mal um einen Login bitten. Wer mehrere KI-Apps auf dieselben Konten loslässt, kennt das Problem.
    • Jeder der 35 Bestands-Skills wuchs um exakt +59 Zeilen (+2.977 Bytes). Zwei neue Standards wurden per Skript in alle Skills gekachelt: explain useful connections in every article opening (14.09.) und reuse existing authorized access (21.09.). Ein einheitliches Delta über 35 Dateien ist die Signatur von Standards-as-Code: Regel einmal schreiben, überall einspielen.
    • Die Grokipedia-Notbremse steht jetzt im Skill selbst. Der Stopp für Client-Einreichungen (Warteschlange seit April eingefroren) steht seit dem 16.09. ganz oben im Skill und in dessen Beschreibung — vorher lag er in einer Sidecar-Datei, die man übersehen konnte.

    Was der Lauf gebaut hat

    Weil sich die Quelle geändert hat, hat der Lauf mein Plugin neu gebaut: blitzmetrics-skills v2.6.0 — 36 Skills, 114 Dateien, 1,59 MB, claude plugin validate bestanden. Unterwegs fielen drei Skills mit kaputtem YAML-Frontmatter auf (ungeschützter Doppelpunkt in der Beschreibung: boil-the-ocean, one-session-client-onboarding, social-amplification-engine) — dieselbe Fehlerklasse, die der Juli-Lauf schon einmal gefixt hat, nur in neuen Dateien. Fix: Beschreibung als YAML-Blockskalar, sonst nichts angefasst.

    Was kaputt war, wo ich raten musste

    Die Registry-Webseiten waren für den unbeaufsichtigten Lauf nicht abrufbar — der Abruf verlangt eine interaktive Freigabe, und während eines geplanten Laufs sitzt da niemand. Der Lauf hat deshalb das Repo als Primärquelle genommen (ohnehin die bessere Quelle; der Seiten-Gegencheck fehlt diese Woche schlicht). Das Versionsschema war meine Vermutung: Der alte Zähler ist mit den ZIPs gestorben, also spiegelt v2.6.0 die Upstream-Marketplace-Version 1.6.0 — eine Vermutung ist eine fehlende Anweisung, deshalb steht sie hier. Zwei Altlasten-Skills (personal-brand-strategist, personal-brand-website-agent) existieren nur im Juli-ZIP und in keinem Speicher, den dieser Lauf erreichen konnte; sie sind nicht mehr im Paket — wer das Update einspielt, verliert sie. Wiederherstellung: die lokalen Kopien im Skill-Files-Ordner.

    Noch eine Premiere: Dieses Protokoll hat sich selbst veröffentlicht. Die drei Vorgänger-Läufe endeten als unveröffentlichte Dateien, weil die Site unauthentifiziertes Posten ablehnte; ein gespeichertes Application Password hat diese Drei-Wochen-Lücke heute geschlossen.

    Was sich am SOP ändert (v1.3)

    Ab diesem Lauf: Git-Diff gegen das Repo statt ZIP-Vergleich, Plugin-Build direkt aus dem Repo, Manifest weiter wöchentlich nach Drive. Offener Vorschlag: die Schritte 2/2.5 im Prompt des geplanten Tasks umschreiben — sie beschreiben noch die tote ZIP-Mechanik. Das Vorgänger-Protokoll dieser Serie: Wie ich meine gesamte Projektverwaltung an einem Nachmittag mit Claude gebaut habe.
  • Wie ich meine gesamte Projektverwaltung an einem Nachmittag mit Claude gebaut habe

    Wie ich meine gesamte Projektverwaltung an einem Nachmittag mit Claude gebaut habe

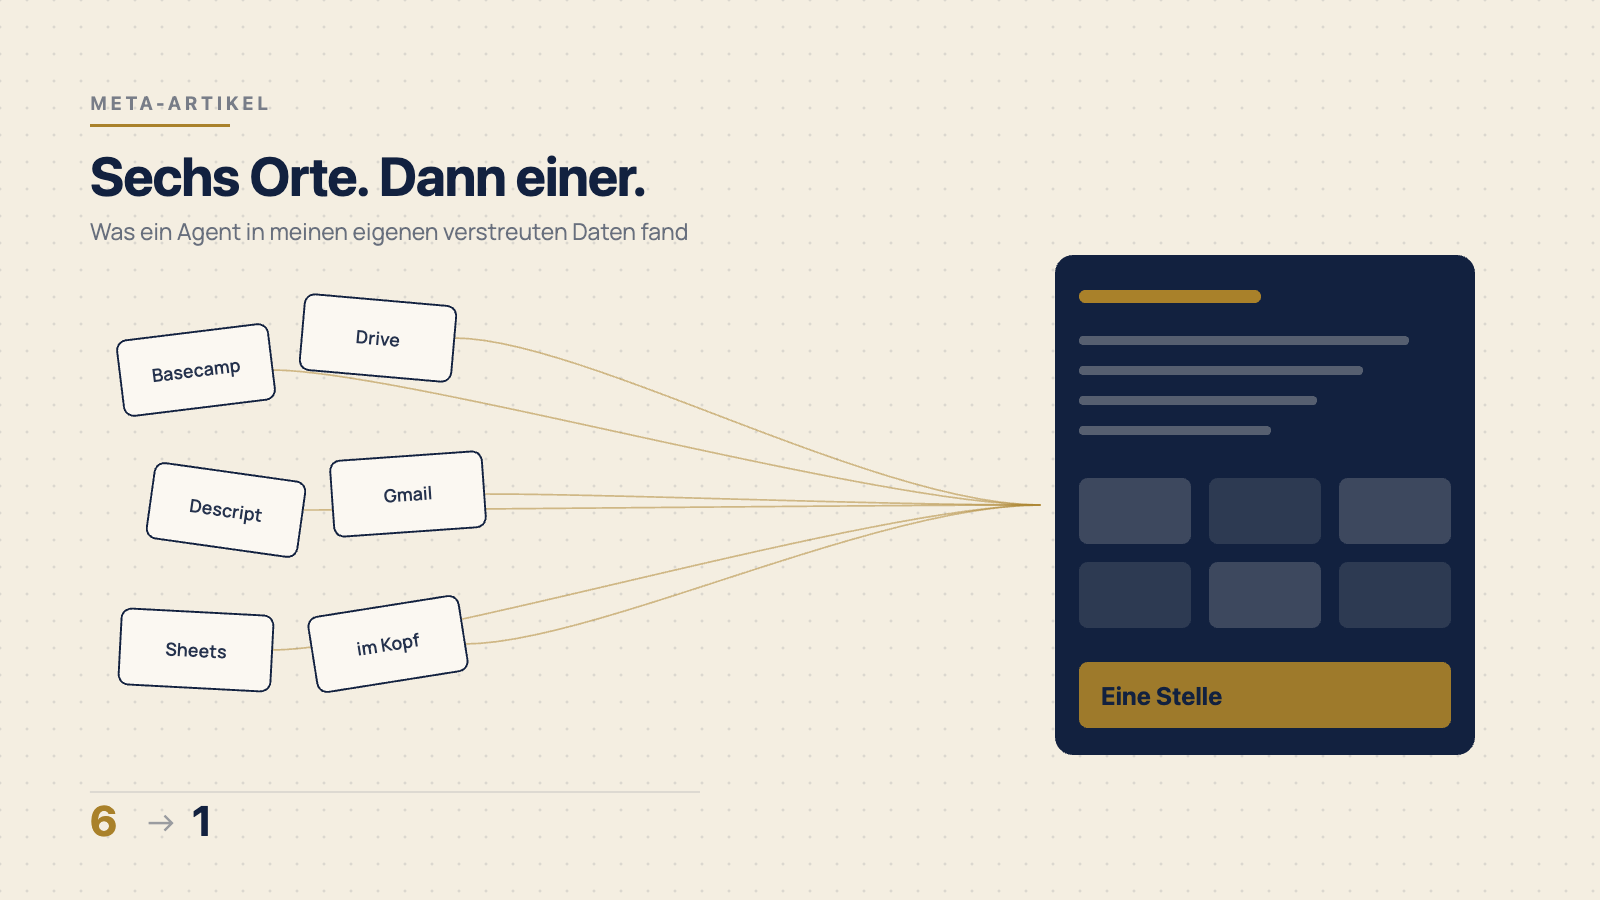
    Sechs verstreute Werkzeuge laufen in einer einzigen Projektübersicht zusammen

    Meta-Artikel · Juli 2026

    Das hier ist ein Meta-Artikel: die Dokumentation dessen, was tatsächlich passiert ist. Nicht die geglättete Version, sondern der Ablauf mit den Entscheidungen, den Sackgassen und den Fehlern, die dabei auffielen. Wer denselben Weg gehen will, soll ihn nachvollziehen können.

    Die Aufgabe

    Was war das Problem. Meine Projekte lagen an sechs Stellen: Basecamp für die Aufträge des Teams, Google Drive für Dateien und Rechnungsentwürfe, Descript für Videoschnitt, Gmail für alles Abgesprochene, ein Google Sheet für die Content-Bibliothek, und der Rest im Kopf. Wenn Dennis fragte, wie weit etwas sei, musste ich drei Tabs öffnen. Bei der Wochenabrechnung sammelte ich von Hand zusammen, was in den letzten sieben Tagen fertig geworden war.

    Das Ziel. Eine Stelle, an der ich sehe, wo ich stehe. Mit Abrechnung, weil die Abrechnung der Punkt ist, an dem Unordnung Geld kostet.

    Das Ausgangsmaterial. Mein Gmail-Postfach, der Google Kalender, Google Drive, Descript und Zoom — alle als Connectoren angebunden. Kein Briefing, keine Vorarbeit. Genau das war der Test: Kann ein Agent aus dem, was ohnehin da ist, ein arbeitsfähiges System bauen?

    Der Ablauf

    Schritt 1: Fragen, bevor gebaut wird

    Claude hat nicht sofort losgelegt, sondern vier Dinge gefragt: Wie soll gespeichert werden? Wie rechne ich ab? Was will ich pro Projekt sehen? Wo soll das laufen?

    Das klingt nach einer Kleinigkeit, ist aber der Grund, warum das Ergebnis brauchbar wurde. Auf die Frage nach der Abrechnung habe ich geantwortet, dass ich Festpreise für Podcasts habe — zum Beispiel ein Euro pro roher Minute —, aber auch Artikel und Gewinnbeteiligungen. Hätte niemand gefragt, wäre ein Stundensatz-Werkzeug herausgekommen, das ich nicht benutzen kann.

    Schritt 2: Die Dienste durchsehen

    Claude hat Gmail, Kalender, Drive und Descript durchgearbeitet und daraus die Wirklichkeit rekonstruiert: acht Kunden, dreizehn laufende Projekte aus Basecamp-Threads und Mailverläufen, vierzehn offene Aufgaben mit echten Fristen, und mein Abrechnungsmodell aus einem Rechnungsentwurf im Drive — ein Euro pro Rohminute, zehn Euro pro Artikel, Aufwandsgrößen Small, Medium und Large zu zwanzig, vierzig und hundert Dollar, Kleinunternehmerregelung, vierzehn Tage Zahlungsziel, Rechnungsnummern nach dem Schema LP-JAHR-NNN.

    Der interessante Teil war nicht die Menge, sondern was dabei sichtbar wurde. Vier Posten in meiner Wochenübersicht waren als “nicht Leo” markiert — strittige Zuordnungen, über die ich mit niemandem gesprochen hatte. Eine Zahlung war seit Tagen offen. Ein Kunde wartete seit zwei Tagen auf eine Antwort. Das lag alles offen in meinen eigenen Daten und ich hatte es nicht gesehen, weil es an sechs Stellen verteilt war.

    Schritt 3: Bauen

    Herausgekommen ist eine einzelne HTML-Datei. Kein Server, kein Konto, keine Cloud. Sie liegt auf meinem Rechner, ich öffne sie im Browser, die Daten bleiben im Browser gespeichert. Dazu ein Export als Sicherungsdatei.

    Warum eine Datei und keine Web-App? Weil ich sie besitze. Kein Abo, das ausläuft, kein Anbieter, der zumacht, keine Frage, wem meine Kundendaten gehören. Der Preis dafür: die Daten hängen an einem Browser auf einem Rechner. Deshalb der Export — ohne den wäre der Ansatz fahrlässig.

    Das Datenmodell umfasst zehn Bereiche: Kunden, Projekte, Aufgaben, Claude-Projekte, Zeiten, Rechnungen, Ausgaben, Ideen, Termine und Aufträge. Elf Ansichten, darunter ein Tagescockpit, ein Wochenblick, Projekt-Boards zum Ziehen, Zeiterfassung mit Timer und eine Finanzübersicht mit Steuerrücklage.

    Schritt 4: Der Teil, der wirklich Zeit spart

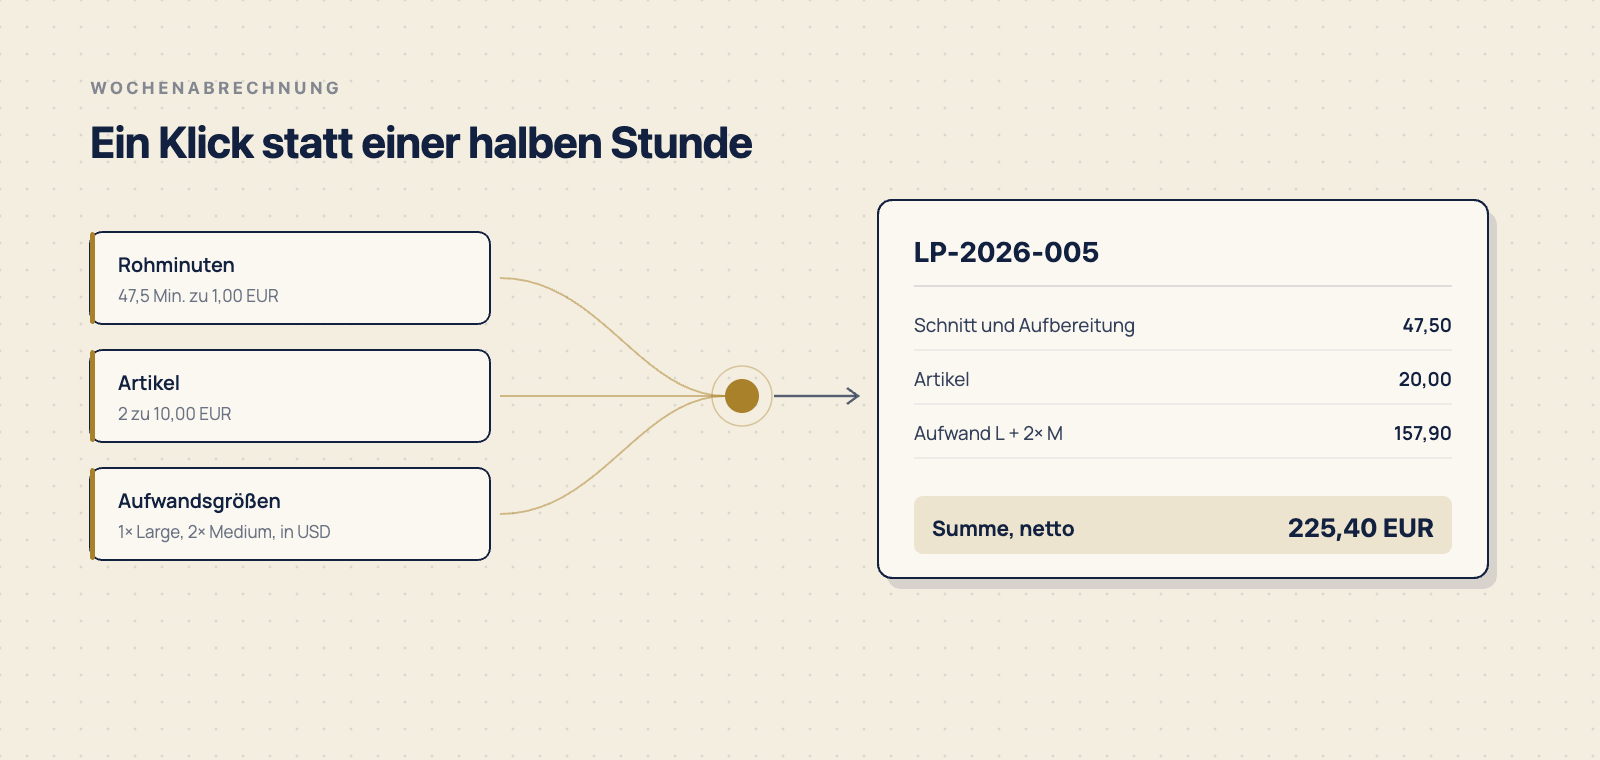
    Die Wochenabrechnung. Sie nimmt alles, was fertig ist und noch auf keiner Rechnung steht, bündelt die Rohminuten zu einer Position, die Artikel zu einer zweiten, die Aufwandsgrößen einzeln, rechnet Dollarbeträge zum hinterlegten Kurs in Euro um, vergibt die nächste freie Rechnungsnummer und markiert die abgerechneten Posten. Ein Klick.

    Vorher war das eine halbe Stunde Handarbeit pro Woche, bei der ich regelmäßig etwas übersehen habe.

    Rohminuten, Artikel und Aufwandsgrößen fließen in eine erzeugte Rechnung zusammen
    Die Wochenabrechnung: Rohminuten, Artikel und Aufwandsgrößen werden zu einer Rechnung gebündelt, Dollarbeträge zum hinterlegten Kurs umgerechnet.

    Die Entscheidungen, über die es sich zu reden lohnt

    Einzelposten vor der Summe auf Cent runden. Beim Testen fiel auf: Drei Aufwandsgrößen zu hundert, vierzig und vierzig Dollar ergaben bei Kurs 1,14 die Einzelbeträge 87,72, 35,09 und 35,09 Euro. Zusammengezählt sind das 157,90. Die App rechnete aber intern mit den ungerundeten Werten und kam auf 157,89. Ein Cent — auf einer Rechnung, auf der die Einzelposten sichtbar sind, ist das ein Fehler, den ein Buchhalter findet und der Vertrauen kostet. Jetzt wird jede Position auf Cent gerundet, bevor summiert wird.

    Rohminuten bündeln statt einzeln auflisten. Eine Rechnung mit einer Zeile “Schnitt und Aufbereitung: 47,5 Rohminuten” liest sich besser als zwölf Zeilen mit je 3,9 Minuten. Die Einzelposten stehen weiter in der App, auf der Rechnung stehen sie zusammengefasst.

    Der Fortschritt rechnet sich aus den Aufgaben. Solange ein Projekt Aufgaben hat, ist der Prozentbalken nicht eintippbar. Ein selbst gesetzter Fortschritt ist eine Behauptung; abgehakte Aufgaben sind eine Tatsache.

    Ein Feld für den nächsten Schritt. Jedes Claude-Projekt hat es. Die App warnt, wenn Projekte in Arbeit sind, bei denen es leer ist. Genau die bleiben liegen — nicht weil sie schwer sind, sondern weil unklar ist, womit man anfängt.

    Getestet, nicht gehofft

    Vor der Übergabe liefen automatisierte Durchläufe im Browser: die App wird in einer simulierten Umgebung geladen, es werden Projekte angelegt, Positionen eingetippt, Rechnungen erzeugt, gedruckt, Status gewechselt, die App neu gestartet. Insgesamt 138 Prüfungen über drei Ausbaustufen.

    Gefunden wurden drei echte Fehler. Die beschriebene Cent-Differenz zwischen Einzelposten und Rechnungssumme. Ein ungeschützter Zugriff auf ein Eingabefeld, das nicht mehr da war, wodurch die Suchleiste abstürzte, wenn man sie schnell wieder schloss. Und ein Ja-Nein-Feld, das als Text statt als Wahrheitswert gespeichert wurde und deshalb einen Neustart nicht überlebte.

    Alle drei wären mir im Alltag begegnet. Der dritte hätte Daten stillschweigend verloren.

    Was danach dazukam

    Ein Auftragskanal. Ich kann jede Aufgabe und jedes Projekt an Claude übergeben. Ein Klick erzeugt ein vollständiges Briefing — nicht nur mein Stichwort, sondern automatisch mein Abrechnungsmodell, das zugehörige Projekt mit Beschreibung und offenen Punkten, der Kunde mit Kontaktdaten und Hintergrund, die Fristen. Ich muss nichts erklären, was ohnehin im System steht. Zurück kommt ein Datenblock, den die App wieder einliest.

    Ein Morgenlauf. Werktags um halb acht werden Posteingang, Kalender und Fristen durchgesehen, offene Aufträge abgearbeitet, Mailentwürfe angelegt und ein Lagebericht hinterlegt. Entwürfe, wohlgemerkt — gesendet wird nichts ohne mich.

    Ein Live-Cockpit. Eine Seite, die Kalender, Posteingang und die laufenden Automatisierungen bei jedem Öffnen frisch zieht.

    Das Ergebnis

    Eine Datei, rund 4.600 Zeilen, keine Abhängigkeiten außer einem Browser. Befüllt mit dreizehn echten Projekten, acht Kunden, vierzehn Aufgaben, zwölf Claude-Projekten und zwei Rechnungen — alles aus Daten, die schon da waren.

    Was ich vorher nicht wusste und jetzt sehe: dass zwei Automatisierungen für mich liefen, an die ich nicht mehr gedacht hatte. Eine davon baut freitags einen Rechnungsentwurf — also genau das, was die neue Wochenabrechnung auch tut. Doppelte Arbeit, die niemandem aufgefallen wäre, wenn nicht beide auf derselben Seite gestanden hätten.

    Das ist der eigentliche Nutzen einer Übersicht. Nicht das Verwalten. Das Sichtbarwerden.

    Für den nächsten Durchgang

    • Die Fragen am Anfang haben mehr gebracht als jede spätere Korrektur. Wer sofort loslegt, baut am Bedarf vorbei.
    • Ein Agent, der die eigenen Daten durchsehen darf, findet Dinge, die man selbst übersieht — nicht weil er klüger ist, sondern weil er alles gleichzeitig anschaut.
    • Automatisierte Tests sind bei generiertem Code nicht optional. Drei Fehler in einem Nachmittag, davon einer mit Datenverlust.
    • Doppelungen im eigenen System findet man erst, wenn alles an einer Stelle steht.

    Dieser Artikel folgt dem Meta-Artikel-Verfahren von BlitzMetrics: Wer eine Aufgabe ausführt, dokumentiert, was tatsächlich getan wurde — damit der nächste Durchgang davon lernt.

    English version: read it here

    Mehr: KI-Systeme & Automatisierung